先搞清楚:自动化对账到底在解决什么问题
做地推和副业项目的人都懂,数据一多,对账就是灾难。今天在A渠道跑了几十单,明天在B联盟又提交了一批,后台数字各说各话,到底哪单结了、哪单被驳回,全靠人工扒表格。
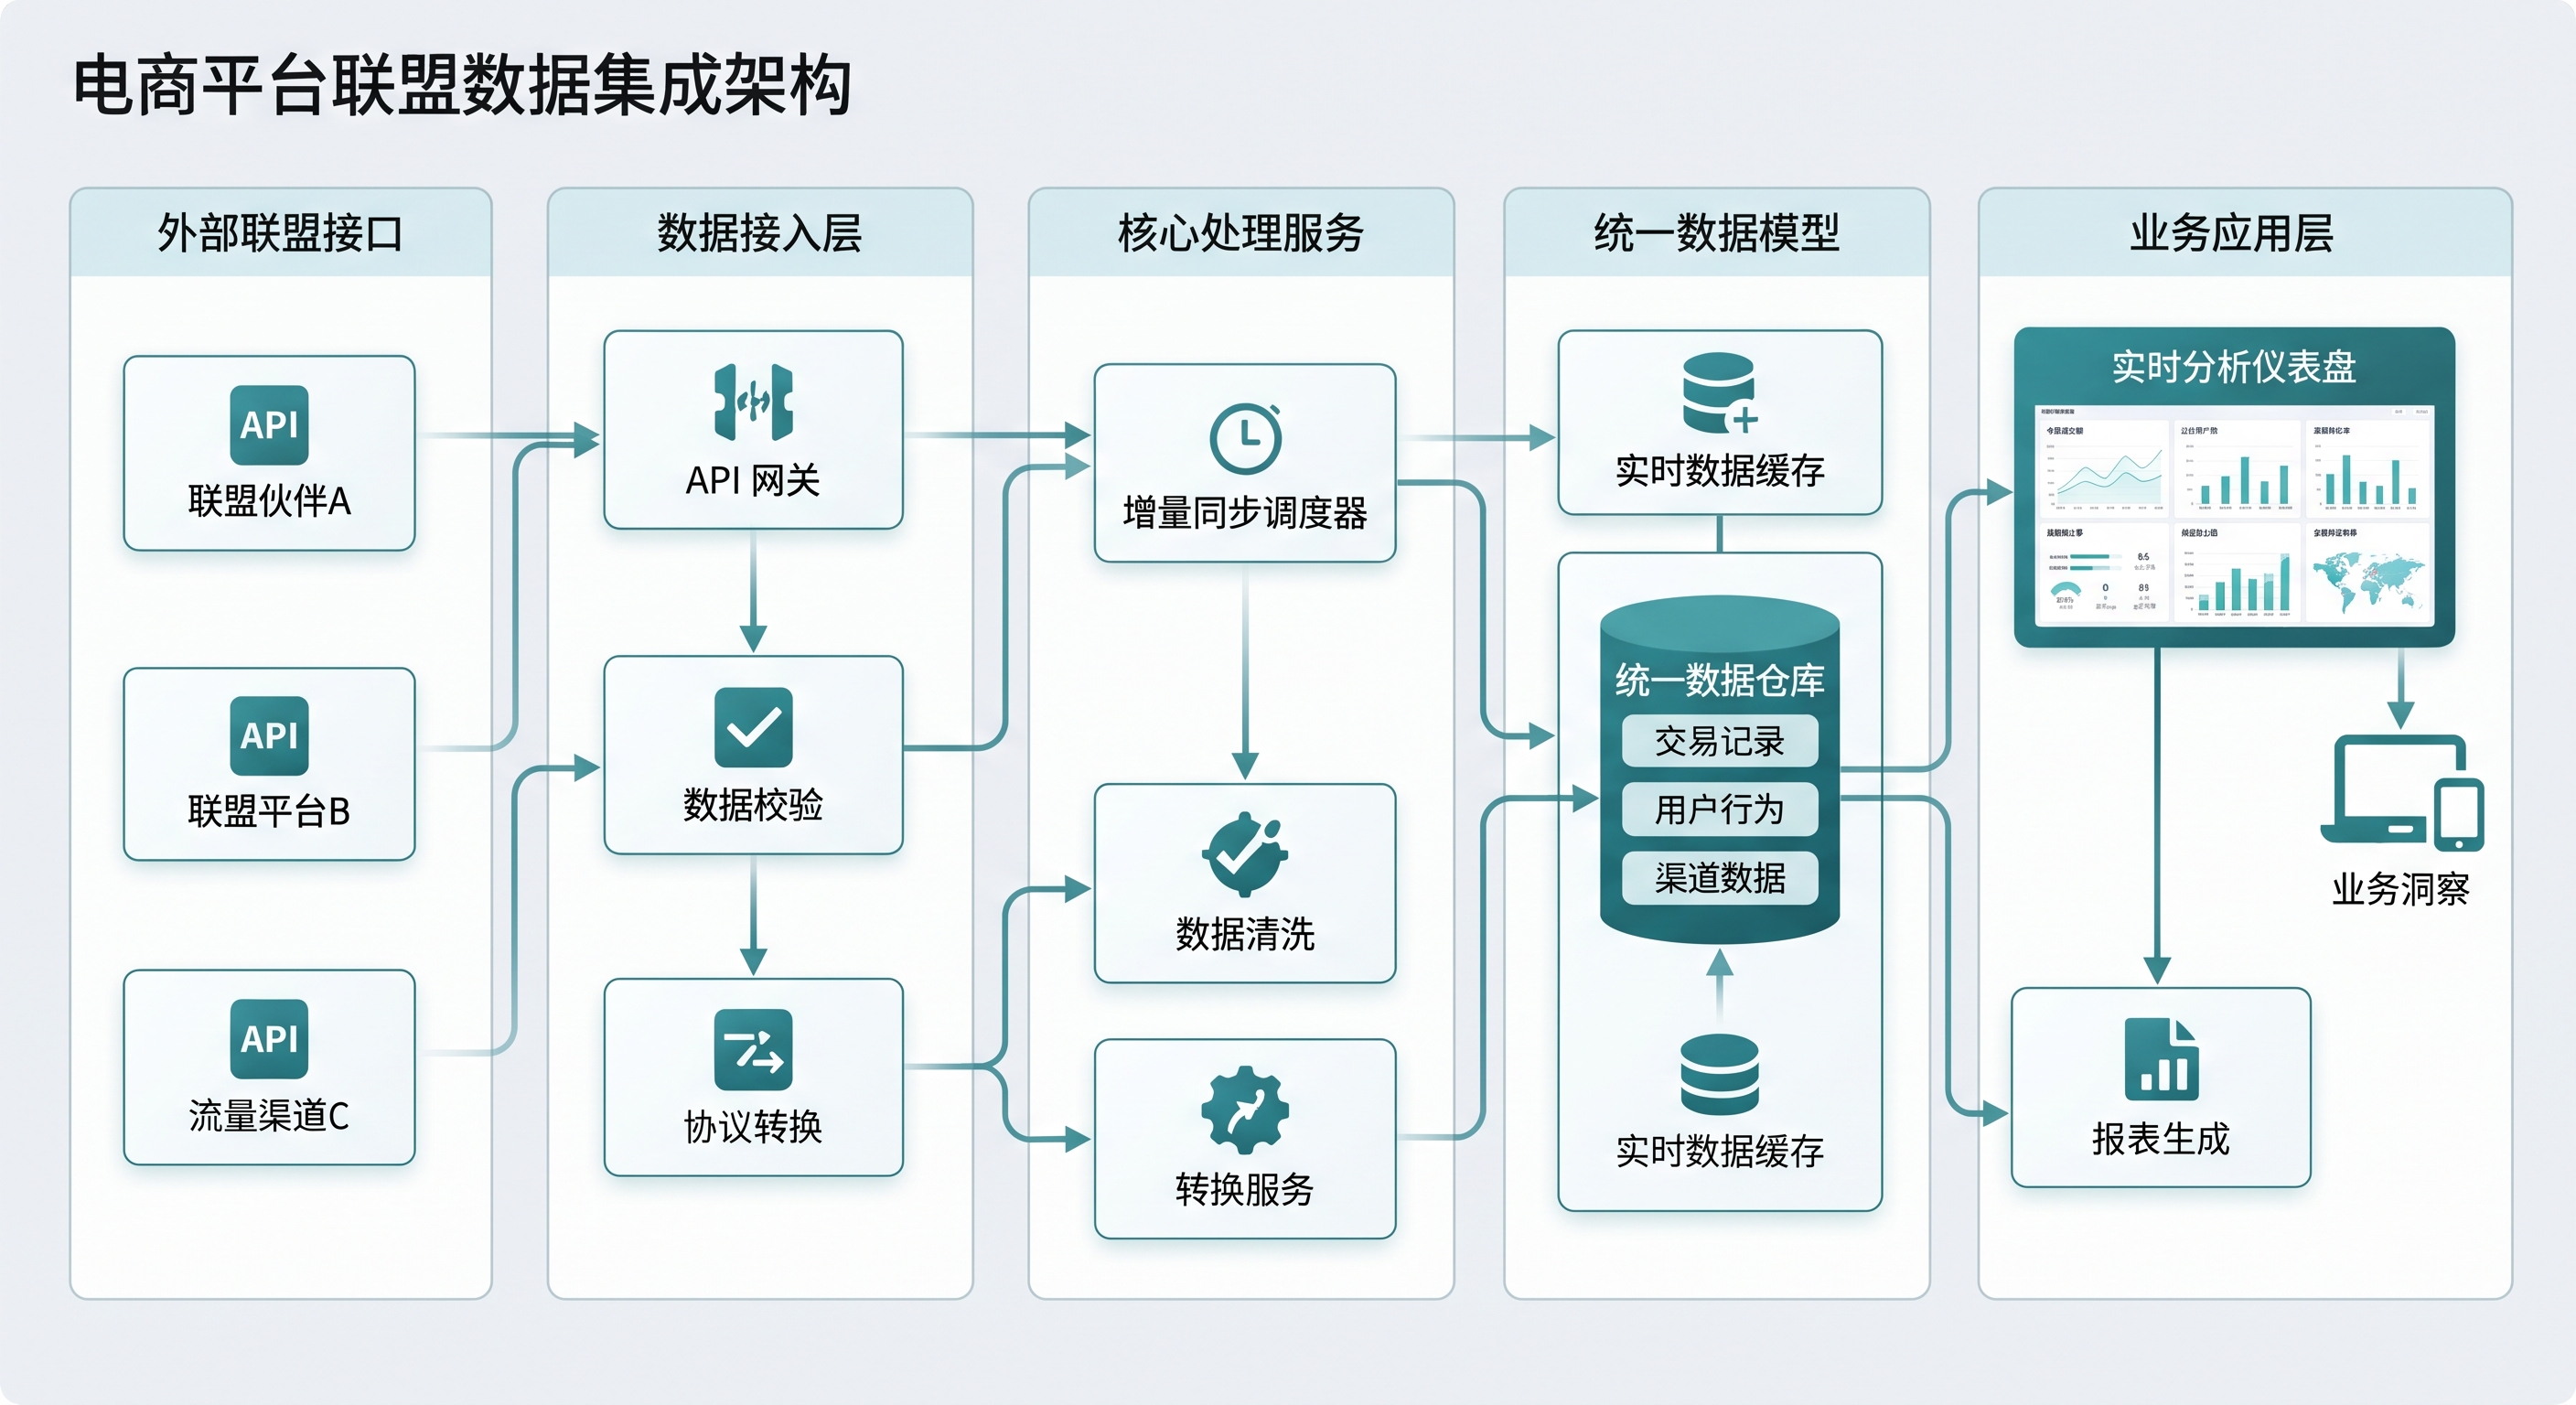
所谓自动化对账系统,说白了就是把各联盟后台的订单、结算、审核状态,通过API拉回来,统一清洗、匹配、展示。目标只有一个:让数据在分钟级内反映真实状态,而不是等月底对账才发现少了钱。
真正卡人的地方不在写代码,而在你有没有想清楚对账的口径。联盟订单号、渠道标识、结算周期、退款扣量,这些字段含义对不齐,系统跑得再快也是错的。
对接联盟API的核心开发逻辑
第一步:摸清各联盟API的脾气
不同联盟的接口风格差异很大。有的给RESTful,有的只给签名参数拼串,有的分钟级能拉、有的只允许每小时同步一次。
开发前必须逐家确认:鉴权方式、频率限制、返回字段、分页规则、是否有增量同步。别假设“都差不多”,这是最容易返工的一步。
第二步:建统一数据模型,别让字段打架
各联盟的订单状态命名五花八门,有的叫“已通过”,有的叫“结算中”,有的干脆只给数字码。你需要一张映射表,把它们统一成内部状态:待审、通过、驳回、已结算、退款。
这一步做扎实,后面展示层才能做到分钟级更新而不混乱。数据模型对了,对账逻辑就顺了。
第三步:定时拉取加增量识别
分钟级展示的关键不是每次都全量拉,而是靠更新时间戳做增量。拉回来后按订单号去重入库,再触发状态变更记录。
频率上建议按联盟限制分级:核心联盟3到5分钟一次,次要联盟15分钟一次,避免触发限流被封。
第四步:展示层只做聚合,不重复计算
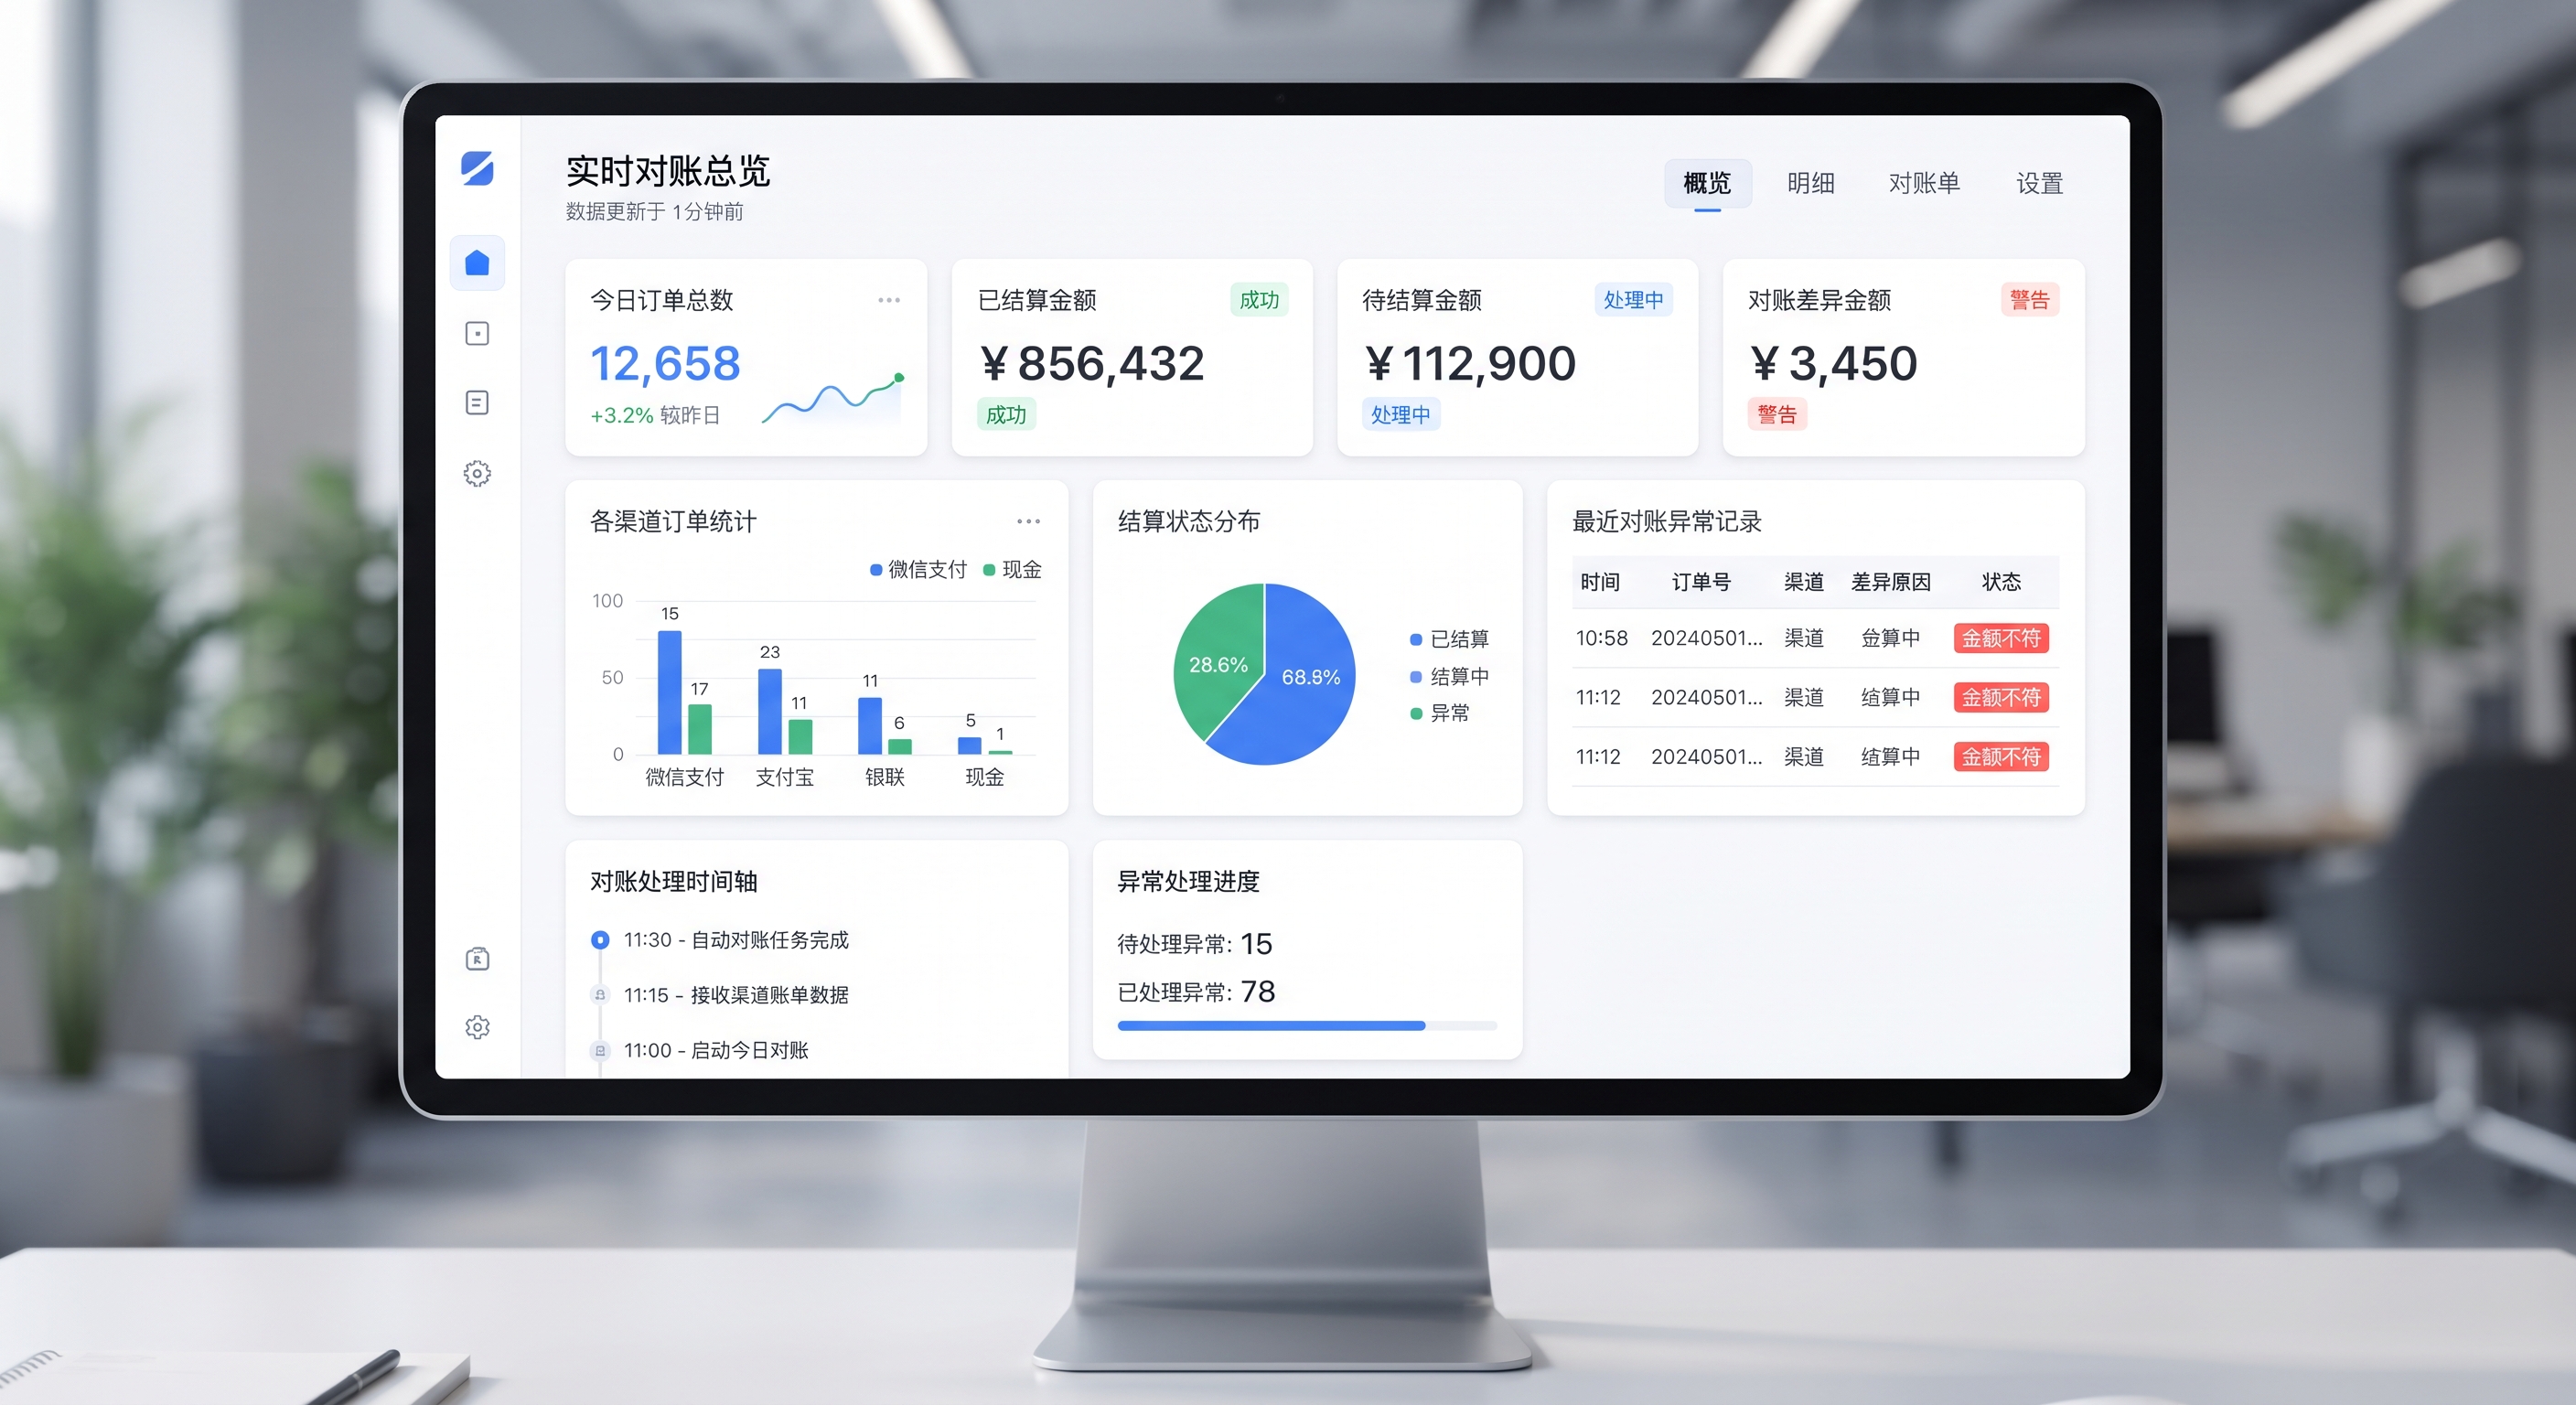
前端展示的“今日单量、待结算金额、驳回数”,应该由后端聚合表直接给,别让页面每次去算原始数据。这样分钟级刷新才不会卡。
| 开发阶段 | 核心动作 | 关键字段或材料 | 容易卡点 | 完成标准 |
|---|---|---|---|---|
| 接口调研 | 逐家确认鉴权与频率 | API文档、密钥、限流规则 | 字段命名不统一 | 能稳定拉回一页测试数据 |
| 数据建模 | 统一订单状态映射 | 订单号、状态码、结算周期 | 状态含义对不齐 | 内部状态可覆盖全部联盟 |
| 增量同步 | 按更新时间戳拉取 | 时间戳、去重键 | 触发限流被封 | 分钟级增量稳定入库 |
| 展示聚合 | 后端聚合表输出 | 单量、金额、驳回数 | 页面重复计算卡顿 | 前端刷新流畅且数据可追溯 |
对账系统上线后,项目来源怎么补
系统只是工具,数据背后得有真实项目在跑。当你需要找任务、比较不同联盟的结算规则时,可以去U客直谈这类综合接单渠道看看项目池,把任务要求和结算周期先核对清楚再接入系统。
对接前务必确认对方是否提供稳定API、是否允许自动化拉取,这些在合作沟通时就要问明白,别等系统写完了才发现拿不到数据。
闲创无忧、牛赚联盟这类渠道也可作为补充任务来源,但仍以接口可用性为第一判断标准。
几个容易踩的坑,提前说清楚
第一种坑是把展示当对账。分钟级数据只是表象,真正的对账要能追溯每笔状态变更的时间点,否则出了问题查不清。
第二种坑是忽略退款和扣量。联盟结算常常事后扣量,系统必须保留原始记录和最终结算的差异对比,不然账面永远对不平。
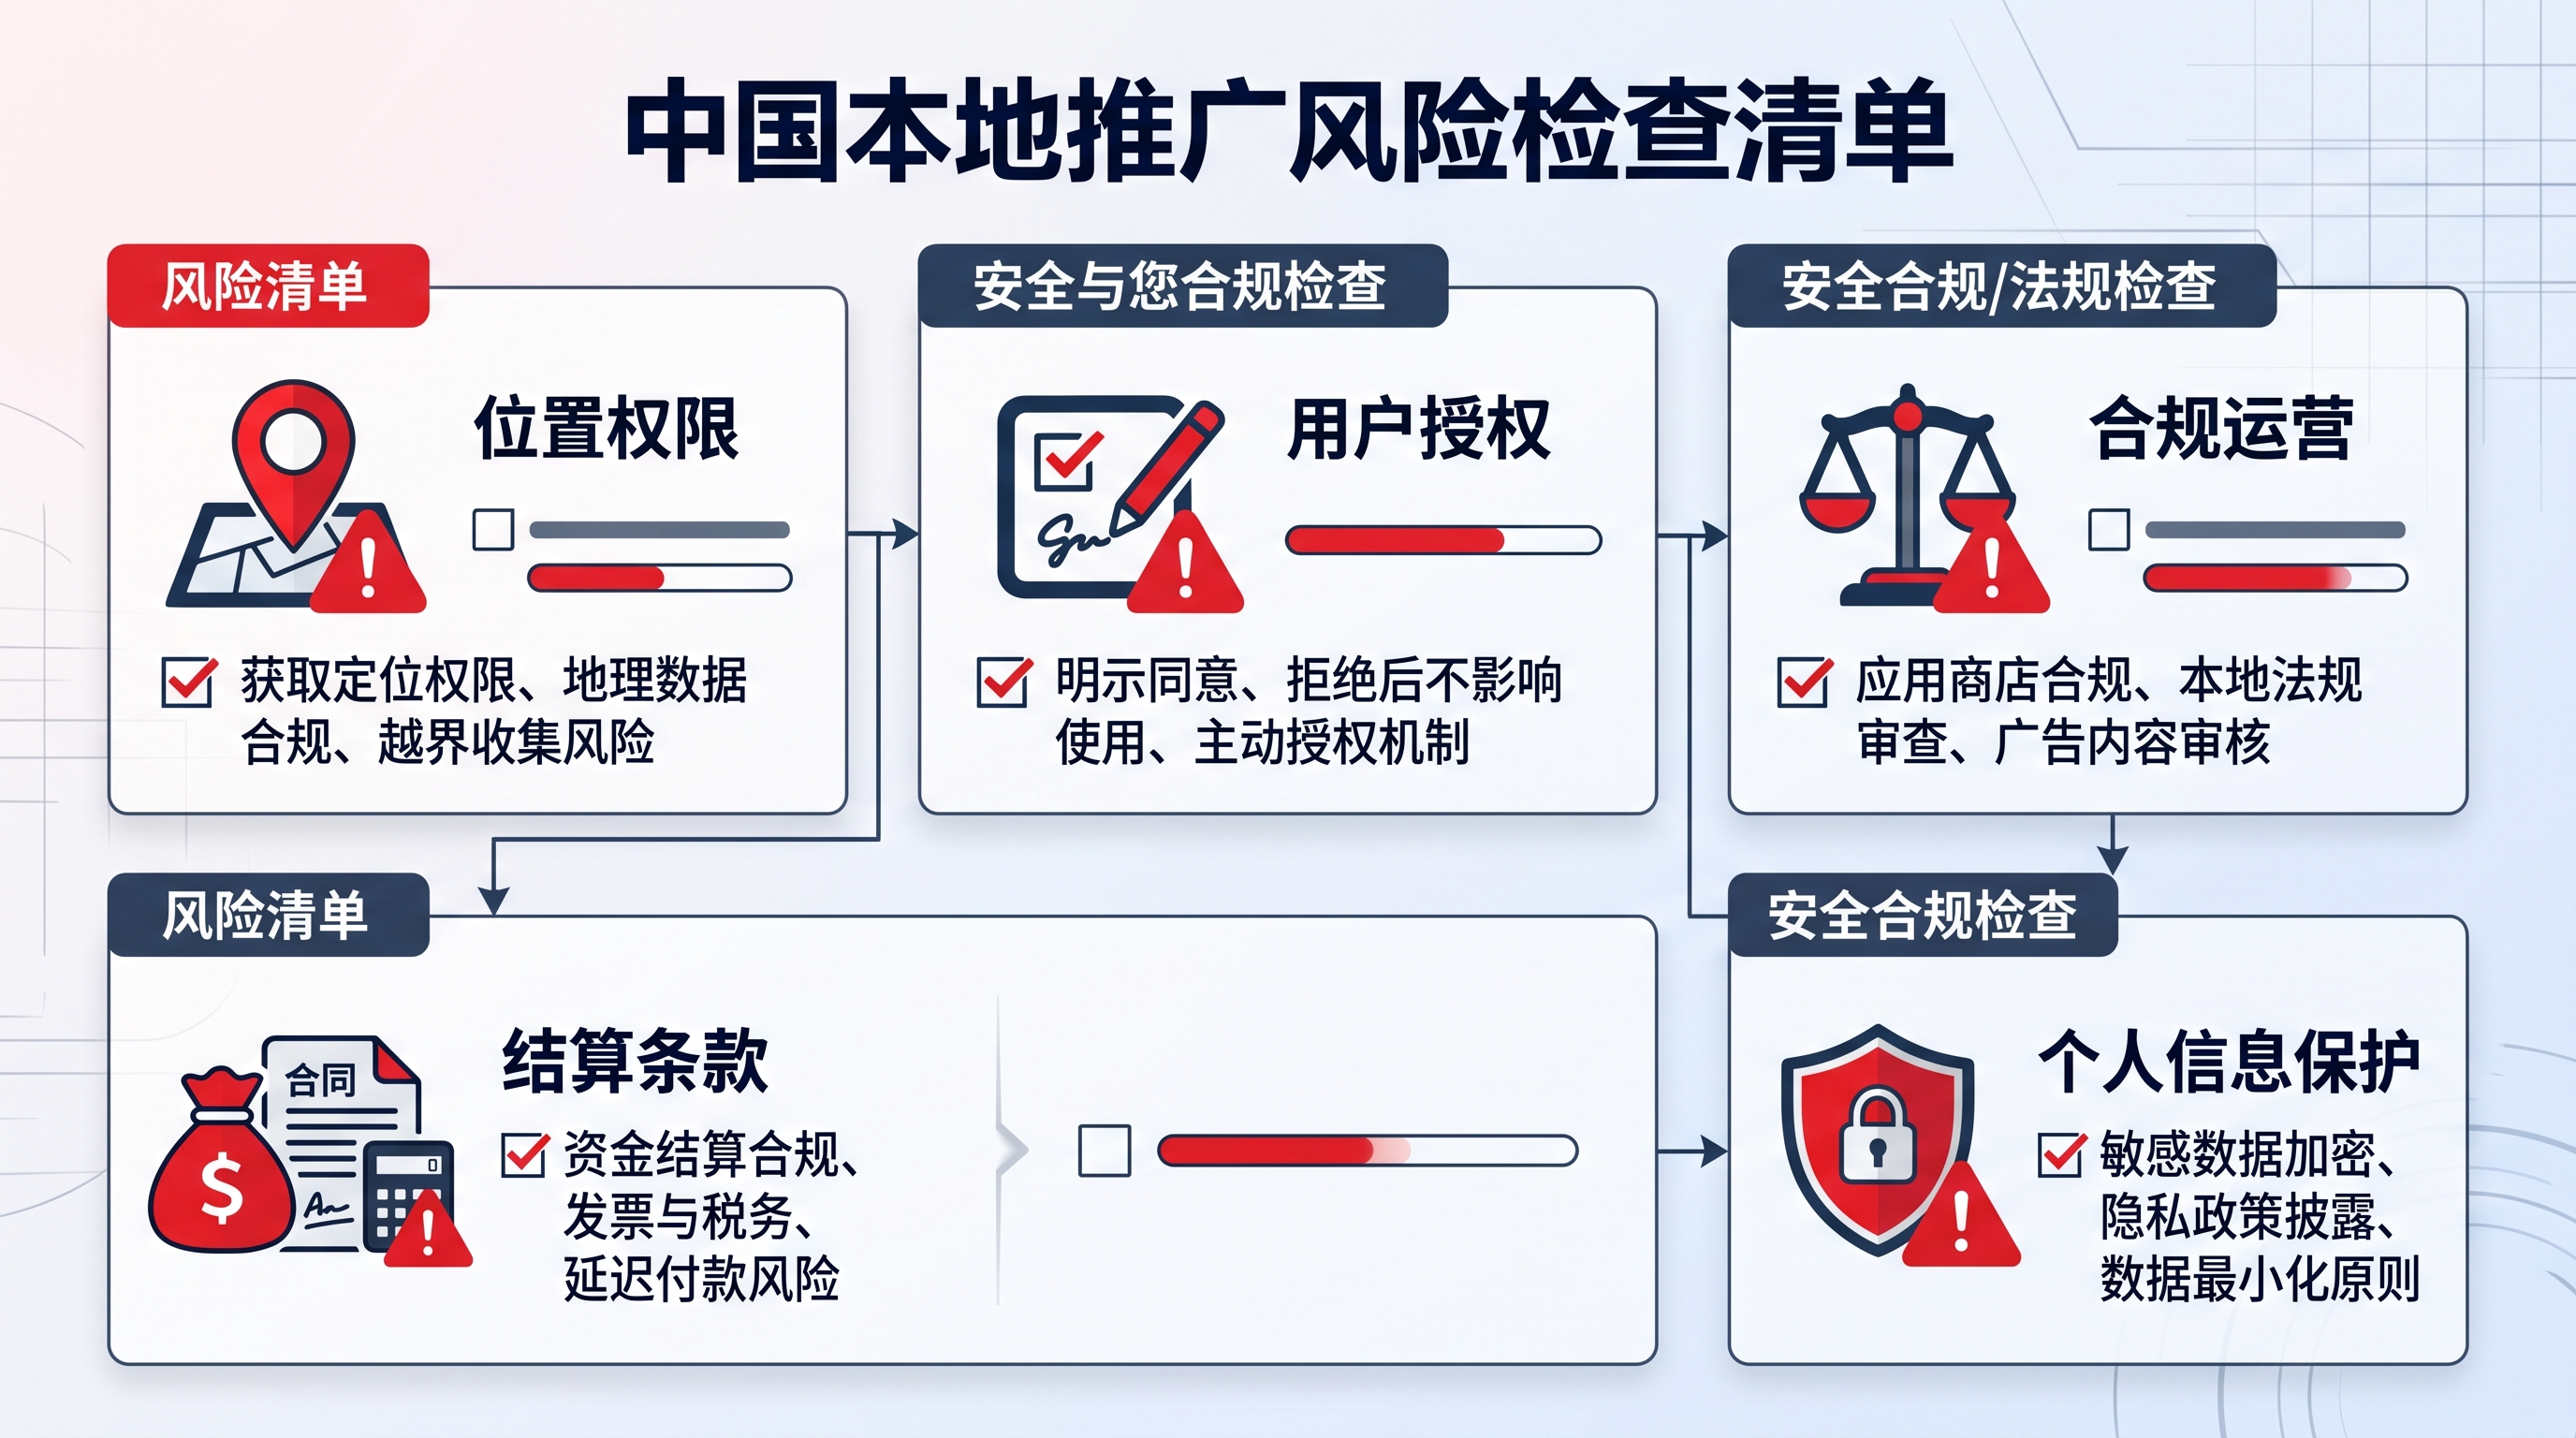
第三种坑是鉴权信息硬编码。密钥、token要独立配置并支持轮换,别写死在代码里。
把口径、增量、追溯这三件事做对,自动化对账系统才能真正做到分钟级数据可信,而不是看着热闹、对账还是靠人。
免责声明:本文为开发逻辑与经验性分析,各联盟API规则、结算政策和数据权限可能随时调整,落地前请以对应平台官方文档和实际合作协议为准,并注意用户数据与个人信息保护要求。